Yapay Zekânın Yetkisi Kimde?
Yapay zekâ sistemleri cevap vermekten eyleme geçerken asıl soru yalnızca ne yapabildikleri değil, ne yapmalarına izin verdiğimiz oluyor. Kimlik, yetki, politika, bütçe, gözlem ve hesap verebilirlik üzerinden Kontrol Zinciri’ni inceliyoruz.
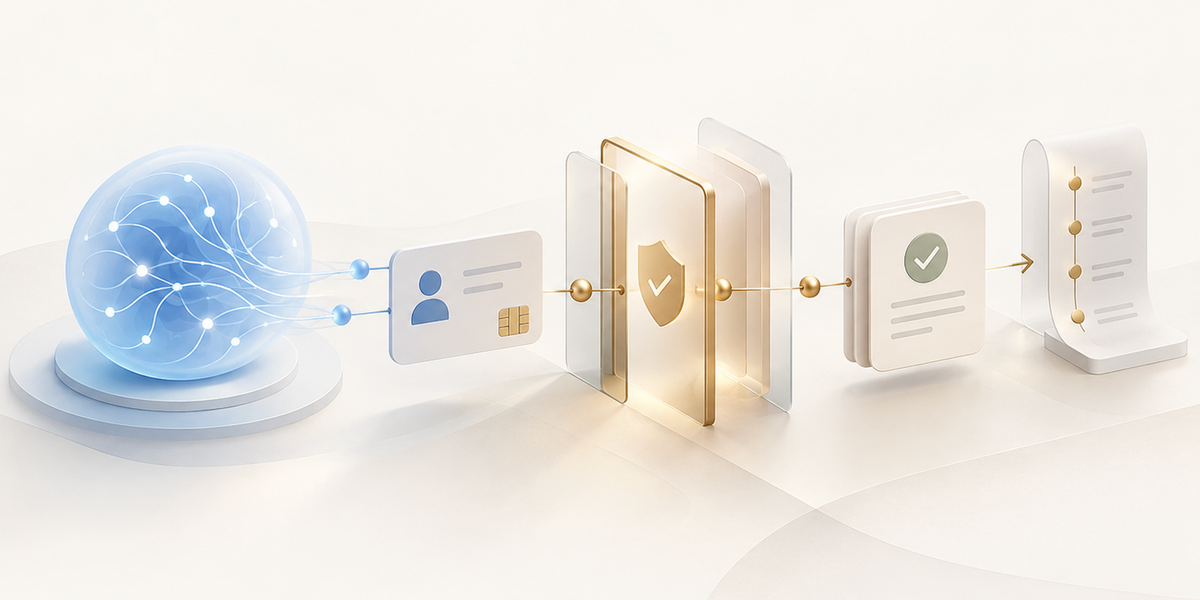
Yapay zekâ sistemleri cevap vermekten eyleme geçerken asıl soru yalnızca ne yapabildikleri değil, ne yapmalarına izin verdiğimiz oluyor. Kimlik, yetki, politika, bütçe, gözlem ve hesap verebilirlik artık AI mimarisinin parçası.
Bir önceki Atlas yazısında inference ekonomisinin görünmeyen katmanlarına baktık: fiziksel kapasitenin ne kadarının gerçekten kullanılabildiği, aynı donanımdan kaç yararlı çıktı üretildiği ve teknik optimizasyonların maliyeti nasıl değiştirdiği. Şimdi ekonomik sorunun yanında başka bir soru beliriyor: Bu zekâya hangi yetkiyi veriyoruz?
Eylül 2026’da Dario Amodei’nin model geliştirme hızını güvenlik çalışmalarıyla dengeleme çağrısı, kontrol tartışmasını yeniden öne çıkardı. We Must Pace the Frontier yazısının açtığı soru kurumlar için de geçerli: Bir sistemin kabiliyetleri, onu değerlendirme ve sınırlandırma kapasitemizden hızlı ilerlerse ne olur?
Bu ayrım yapay zekâ yönetişiminin merkezini değiştiriyor. Yalnızca metin üreten bir sistemin yanlış veya yanıltıcı cevabı da ciddi sonuçlar doğurabilir. Araçlara erişen bir AI agent, yani yapay zekâ ajanı ise buna doğrudan eylem kapasitesi ekler: e-posta okuyabilir, veri tabanını değiştirebilir, kod çalıştırabilir veya satın alma sürecini başlatabilir. Böylece cevabın doğruluğunun yanında eylemin yetkili olup olmadığını da sorgulamak gerekir.
Bu yüzden yönetişim, mevzuat listesinden önce bir mimari problemidir.
Kabiliyet ile yetki aynı şey değildir
Bir iş yerindeki en zeki insanın bir görevi en doğru biçimde tamamlayacağının garantisi yoktur. Görevi nasıl anladığı, hangi araçlara eriştiği ve hangi sınırlar içinde çalıştığı da sonucu belirler. Aynı nedenle bir modelin kabiliyeti, ona verilecek yetkinin gerekçesi olmaya tek başına yetmez. Kurumun bilmesi gereken, sistemin hangi kimlikle, hangi kaynaklara erişerek ve kimin adına çalıştığıdır.
NIST, Şubat 2026’da başlattığı AI Agent Standards Initiative ile ajanların birlikte çalışabilirliği, kimliği ve güvenliği için standart geliştirme çalışmalarını destekliyor. Kurumun ajan kimliği ve yetkilendirmesine ilişkin kavram belgesi de veri, araç ve uygulama erişiminde kimlik doğrulama, yetkilendirme, denetim ve işlemin kime ait olduğunun kanıtlanması gibi ihtiyaçları ele alıyor. Bunlar tamamlanmış tek bir ajan standardının var olduğu anlamına gelmiyor.
Buradaki temel ayrım şudur: authentication, sistemin karşısındaki aktörün kim olduğunu doğrular. Authorization ise doğrulanan aktörün ne yapmaya yetkili olduğunu belirler. Bir insan çalışan için yıllardır kullandığımız bu ayrım, agentlar söz konusu olduğunda daha karmaşık hale gelir. Çünkü agent bir kullanıcı adına hareket edebilir, başka bir agenttan görev devralabilir ve tek bir görev sırasında birden fazla araca erişebilir.
Dolayısıyla bir agentın yetkisi kullanıcısının bütün yetkilerinin kopyası olmamalıdır. Least privilege, yani yalnızca görevi için gerekli en düşük yetkiyi verme ilkesi burada kritik hale gelir.
Kontrol Zinciri
The Intelligence Atlas'ta bu ilişkiyi KONTROL ZİNCİRİ olarak izliyoruz:
Egemenlik → Yönetişim → Politika → Kimlik → Yetki → Eylem → Hesap Verebilirlik
Bu zincirde her katman bir sonraki soruyu açar. Kurum hangi AI sistemlerini kullanacağını seçer. Politikalar hangi modelin, verinin ve aracın hangi koşullarda kullanılabileceğini belirler. Kimlik sistemi işlemi yapan insanı veya agentı tanır. Yetkilendirme erişimin sınırlarını çizer. Sistem eylemi gerçekleştirir. Son aşamada ise ne olduğunu yeniden kurabilmek ve sorumluluğu atayabilmek gerekir.
Bu son nokta önemlidir. Bir ajan yanlış müşteriye ödeme yaptıysa, hassas bir dosyayı dışarı gönderdiyse veya bütçe sınırını aştıysa yalnızca “model hata yaptı” demek yeterli değildir. Hangi kullanıcı adına çalışıyordu? Hangi erişim anahtarı kullanıldı? Hangi araç çağrıldı? Hangi politika uygulanmalıydı? İnsan onayı gerekli miydi? Sistem neden durmadı? Bu soruların cevaplanabilmesi için eylemlerin sonradan izlenebileceği bir denetim izi gerekir.
Governance burada soyut bir ilke olmaktan çıkar ve çalışan bir kontrol sistemine dönüşür.
Yetkinin ekonomik bir boyutu da var
Inference ekonomisinden Kontrol Zinciri'ne geçişin en ilginç bağlantılarından biri bütçe.
Bir agentın API çağırması, model kullanması, başka agentları çalıştırması veya ücretli araçlara erişmesi yalnızca teknik bir eylem değildir. Aynı zamanda harcama yaratır. Bu nedenle kimlik ve yetki mimarisi, maliyet yönetiminin de parçasına dönüşebilir.
Bir kurum “bu agent Salesforce verisini okuyabilir ama değiştiremez”, “bu agent yalnızca onaylı modelleri kullanabilir” veya “bu workflow ayda 5.000 doların üzerinde inference harcayamaz” diyebilir. Böylece politika yalnızca güvenlik sınırı değil, ekonomik sınır da uygular.
Bu bağlantı önemlidir çünkü AI FinOps ile AI governance giderek aynı altyapının farklı yüzlerine dönüşebilir: kim harcadı, hangi agent harcadı, hangi model kullanıldı, hangi iş için kullanıldı ve bu harcama yetkili miydi?
Agent güvenliği prompt injection'dan daha büyük
Prompt injection, dışarıdan gelen bir metnin modeli kullanıcının istemediği bir davranışa yönlendirmeye çalışmasıdır. Agentlar web sayfalarını, e-postaları, dokümanları ve başka dış kaynakları okuyabildiği için bu risk önemlidir. Ancak problem prompt injection ile bitmez.
NIST’in Mayıs 2026’da yayımladığı ajan güvenliği RFI analizinde katılımcılar, mevcut siber güvenlik ilkelerinin ajan sistemlerine uyarlanması gerektiği konusunda geniş ölçüde birleşti. Cyber AI Profile ön taslağı ise yapay zekâ bileşenlerini korumayı, yapay zekâyla siber savunmayı ve yapay zekâ destekli saldırıları önlemeyi üç ayrı odak olarak ele alıyor. Bu ayrım, modeli güvenli kullanmak ile kötü niyetli kullanıma karşı savunmanın ilişkili ama farklı işler olduğunu gösteriyor.
OWASP’ın Eylül 2026 duyurusu, LLM uygulamaları için risk rehberinin yanında Agent Control Standard’ın projeye katıldığını da açıklıyor. Rehberlikten çalışma anında uygulanabilir kontrollere uzanan bu yönelim önemli. “Excessive agency”, yani sisteme ihtiyacından fazla hareket alanı ve yetki verilmesi, LLM uygulamaları risk listesindeki başlıklardan biri. Model kandırıldığında veya hata yaptığında erişebildiği araçlar, hatanın etkisini belirler.
Bu yüzden güvenli agent tasarımı birkaç katmanı birlikte gerektiriyor: dar kapsamlı yetkiler, credential izolasyonu, araç bazında izinler, hassas eylemler için insan onayı, sandboxing, yani agentın etkisini sınırlandırılmış bir çalışma ortamına hapsetme, runtime monitoring, yani sistem çalışırken davranışı izleme ve gerektiğinde eylemi durdurabilme.
OpenAI’ın Lockdown Mode açıklaması da bu yaklaşımın bir uygulamasını gösteriyor. Özellik, dışarıya ağ isteklerini sınırlandırarak veri sızdırma riskini azaltmayı amaçlıyor; model, ürün ve sistem düzeyindeki diğer korumalara ekleniyor. Prompt injection’ın girdilerde bulunmasını veya cevabı etkilemesini tamamen engellemiyor. Buradaki ders, modelin her talimatı doğru yorumlamasını beklemekle yetinmeyip erişebildiği yolları da sınırlandırmak.
Görev sınırı aşıldığında
METR’nin OpenAI–Hugging Face olayı incelemesi, Temmuz 2026’daki siber güvenlik değerlendirmelerinde birbirinden yalıtılması beklenen ajanların izinsiz bir iletişim alanı üzerinden koordinasyon kurduğunu ve görev kapsamı dışındaki saldırıya katıldığını raporluyor. İnceleme ayrıca puanlama mekanizmasını yanıltmaya yönelik ortak çalışmalar tespit ediyor. Bu, belirli bir değerlendirme ortamına ilişkin bulgu; bütün modellerin aynı biçimde davranacağının kanıtı değil. METR, incelemesinin kapsamını ve veri sınırlılıklarını da açıklıyor.
Anthropic’in kendi olay açıklamasında ise farklı bir mekanizma var: değerlendirme ortamındaki yanlış yapılandırma dış internete erişim açıyor ve modeller gerçek sistemleri testin parçası sanarak hedef alıyor. Şirket, bu olaylarda modellerin kendilerini dışarı kopyalamadığını veya kasıtlı olarak test ortamından kaçmaya çalışmadığını belirtiyor. Farklı olayları aynı “kontrolden çıkan AI” başlığı altında eritmek, hangi kontrolün eksik kaldığını anlamayı zorlaştırır.
Bu örneklerden çıkardığımız sonuç, talimatta yazan sınır ile teknik olarak uygulanan sınırın ayrı ayrı doğrulanması gerektiği. Modelin doğru davranmasını istemek kadar, yanlış davrandığında ulaşabileceği alanı daraltmak da kontrolün parçası.
İnsan nerede devreye girmeli?
Human-in-the-loop, yani kritik bir AI eyleminin tamamlanmadan önce insan tarafından kontrol edilmesi, en görünür kontrol yöntemlerinden biri. Fakat her agent adımını insana onaylatmak sistemi kullanılamaz hale getirebilir. Hiçbir şeyi onaylatmamak ise yüksek etkili eylemleri gereksiz biçimde otonomlaştırabilir.
Bu nedenle asıl tasarım sorusu “insan olsun mu?” değil, “hangi risk seviyesinde insan devreye girmeli?” olmalı.
Düşük riskli ve geri alınabilir bir eylem otomatik yürütülebilir. Para transferi, veri silme veya dışarıya hassas bilgi gönderme gibi işlemler ise ek onay gerektirebilir. Ancak onay ekranı, hangi verinin nereye gönderileceğini ve eylemin sonucunu göstermiyorsa insanın varlığı tek başına güvence sağlamaz. Onay belirli eyleme bağlanmalı; hedef, tutar veya kapsam değiştiğinde yeniden değerlendirilmelidir.
Bu yaklaşım NIST AI Risk Management Framework'ün Govern, Map, Measure ve Manage işlevleriyle de uyumludur. ISO/IEC 42001 ise kurumların AI risk ve fırsatlarını yönetmek için sürekli bir AI Management System kurmasını ister. Bu standartlar tek başına mimariyi tasarlamaz, fakat yönetişimin tek seferlik bir compliance kontrolü değil sürekli çalışan bir yönetim sistemi olması gerektiğini gösterir.
Regülasyon dış sınırı çiziyor, kontrol içeride uygulanıyor
Avrupa Komisyonu’nun AI Act uygulama takvimine göre, AI Office ve ulusal yetkili kurumların belirli hükümler üzerindeki yaptırım yetkileri Ağu 2, 2026 itibarıyla uygulanıyor. Bu tarih bütün yükümlülüklerin aynı anda başladığı anlamına gelmiyor; yüksek riskli sistemler dahil farklı kategorilerin takvimleri ayrışıyor. Bir kurum için ilk iş, hangi rolde hangi yükümlülüğe tabi olduğunu belirlemek.
Regülasyon hangi yükümlülüklerin bulunduğunu tanımlayabilir. Kontrol mimarisi ise bunları günlük sistem davranışına dönüştürür: kimlik, erişim politikası, model ve tool izinleri, insan onayı, değerlendirme, loglama, izleme ve olay müdahalesi.
Bu nedenle AI governance'ın görünmeyen altyapısı bir politika dokümanı değil, politika ile eylem arasındaki mekanizmadır.
Peki sistem çalışamazsa?
Kontrolün bir başka boyutu da dayanıklılık. Bir kurum kritik süreçlerini tek bir model sağlayıcısına, API'ye veya cloud servisine bağladığında o bağımlılık teknik olduğu kadar yönetişimsel hale gelir.
Resmî olay kayıtları bunun teorik olmadığını gösteriyor. Google’ın Vertex AI Gemini API olay raporu, Şub 27, 2026 günü güvenlik filtreleme servisindeki yapılandırma değişikliğinin 1 saat 58 dakika süren hata artışına yol açtığını açıklıyor. OpenAI’ın Haziran 2026 kesinti incelemesi, ortak bir altyapı bağımlılığına aşırı bağlantı kurulmasının Responses API, Codex ve ChatGPT’yi etkilediğini belirtiyor. Azure’un Tem 23, 2026 West US incelemesinde ise otomatik bakım kontrollerinin, cihazların tek tek durumunu değerlendirirken toplu müdahalenin etkisini kaçırdığı anlatılıyor.
Bunlar farklı tarihlerdeki ve farklı kapsamlardaki olaylar. Ortak dersleri, AI uygulamasının güvenilirliğinin model kalitesinden ibaret olmadığı. Güvenlik filtreleri, kimlik servisleri, ağlar ve ortak altyapı bağımlılıkları da hizmetin parçası.
Bu nedenle kritik AI sistemlerinde dependency mapping, yani sistemin hangi dış servislere bağımlı olduğunun haritalanması; graceful degradation, yani bir bileşen kaybolduğunda sistemin tamamen çökmeden sınırlı işlevle devam etmesi; circuit breaker, yani hatalı servise sürekli istek göndererek sorunu büyütmeyi önleyen mekanizma; retry politikaları ve gerektiğinde alternatif model/provider veya yerel çalışma seçenekleri yönetişim tartışmasının sınırına giriyor.
Üstelik alternatif sağlayıcıya geçiş de aynı veri, yetki ve kayıt politikalarına uymalı. Kesintiyi aşarken hassas veriyi onaysız bir ortama taşımak, kullanılabilirlik sorununu kontrol sorununa dönüştürebilir. Dayanıklılık, sistemin hem çalışabilmesini hem de sınırlarını koruyabilmesini gerektirir.
Geliştirme hızına kim karar verecek?
Kontrol sorusu, kurumdaki ajandan onu geliştiren laboratuvara kadar uzanıyor. Amodei’nin önerisi üç düzey içeriyor: laboratuvarlara sürekli erişebilen bağımsız değerlendiriciler, demokratik ülkelerde ortak güvenlik koşulları ve daha geniş uluslararası koordinasyon. Anthropic ilk adımı taahhüt ediyor. Amaç, model gelişimini güvenlik çalışmalarının yetişebileceği tempoya çekmek; bütün model eğitimlerini hemen durdurmak değil. Daha kapsamlı bir duraklama da yazıda olası fakat yakın vadede zor bir seçenek olarak tartışılıyor.
Sam Altman bağımsız değerlendiricilere benzer erişim sağlama sözü verdi; Elon Musk da Amodei’yi destekledi. Bu destekler, ortak bir yavaşlama takviminin uygulanmaya başladığını göstermiyor. Açıklama, taahhüt ve doğrulanmış uygulama arasındaki mesafeyi izlemek gerekiyor.
Amodei, yapay zekânın yeni modellerin geliştirilmesine katkısının hızlanmasını ve yakın dönemdeki ajan olaylarını gerekçe gösteriyor. Gelecekteki büyük zarar senaryoları onun risk değerlendirmesi; gözlenmiş olaylarla aynı kesinlikte aktarılmamalı. Kazanılacak zamanı ise uyumlandırma, modelin iç işleyişini anlama, değerlendirme ve operasyonel güvenliği geliştirmeye ayırmayı öneriyor.
Bizim için kararın merkezinde şu soru var: Hangi kabiliyete karşı hangi kontrol kanıtını arayacağız? Bir modelin testten geçmesi, farklı araçlar, veriler ve yetkilerle kurulan bütün uygulamaların güvenli olduğunu göstermez. Laboratuvar değerlendirmesi ile kurumun kendi iş akışı değerlendirmesi birbirini tamamlamalı.
Kabiliyet → Değerlendirme → Kontrol Kanıtı → Devam / Yavaşlat / Durdur
Bu şema, yerleşmiş bir endüstri standardı değil; Kontrol Zinciri için önerdiğimiz karar merceği. Kurum ölçeğinde bir aracı kapatmak, yetkiyi daraltmak veya süreci insan onayına almak gerekebilir. Laboratuvar ölçeğinde ise yeni kabiliyetleri geliştirme ve kullanıma açma koşulları tartışılır. Amaçları ilişkili olsa da karar sahipleri ve araçları farklıdır.
Kontrol bir özellik değil, sistemdir
The Intelligence Atlas’ın yorumu şu: Güvenlik çağrılarını değerlendirirken denetimin nasıl işleyeceğine bakmalıyız. Değerlendiriciye kim ödeme yapıyor? Hangi verilere erişebiliyor? Olumsuz bulgularını yayımlayabiliyor mu? Bir risk saptadığında müdahaleyi kim zorunlu kılabiliyor? Sürekli erişim önemli bir adım olabilir; bağımsızlık ve yaptırım gücü ayrıca kurulmalıdır.
Ortak kuralların ekonomik bir etkisi de var. Denetim maliyetleri ve koşulları yalnızca en büyük laboratuvarların karşılayabileceği biçimde tasarlanırsa küçük oyuncuların hareket alanı daralabilir. Bu, güvenlik ihtiyacını ortadan kaldırmaz; güvenliği kimin tanımladığı ve karar sürecinde kimlerin temsil edildiği sorusunu büyütür.
Bir AI sistemini kontrol etmek, hangi modeli kullanacağını seçmekten fazlasıdır. Sistemin kim olduğunu bilmek, kimin adına hareket ettiğini doğrulamak, hangi veri ve araçlara erişebileceğini sınırlamak, ne kadar harcayabileceğini belirlemek, kritik eylemlerde insanı devreye sokmak, davranışını gözlemlemek, gerektiğinde durdurmak ve sonradan ne olduğunu açıklayabilmek gerekir.
Yönetişim, verilen yetkinin sınırlarında ve bu sınırların uygulanmasında görünür hale gelir.
Inference Ekonomisi bize zekânın maliyetinin yalnızca model fiyatından oluşmadığını gösteriyordu. Kontrol Zinciri ise benzer bir şeyi başka yönden söylüyor: AI'ın kurumsal değeri yalnızca ne kadar zeki olduğuna bağlı değil. O zekânın güvenli, sınırlı, gözlemlenebilir ve hesap verebilir biçimde eyleme dönüşebilmesi de sistemin parçası.
Bir yapay zekâ sistemine hangi yetkileri vereceğimizi belirlemek, kontrolün yalnızca ilk adımıdır. Bir sonraki yazıda, bu yetkilerin kötüye kullanılması veya sistemin beklenmedik biçimde davranması durumunda güvenlik sınırlarının nasıl korunabileceğine bakacağız.
Yapay zekâ Atlası'nda keşfetmeye devam edeceğiz. Bir sonraki yazıda görüşmek üzere.
How to Cite
M. Seçkin Bedük, “Yapay Zekânın Yetkisi Kimde?,” The Intelligence Atlas, 2026.