AI Fabrikaları: Zekânın Fiziksel Üretim Sistemi
AI fabrikaları yalnızca daha büyük veri merkezleri değil. Arazi, enerji, soğutma, networking, compute ve sermayenin birlikte tasarlandığı yeni bir endüstriyel sistem ortaya çıkıyor.
Bir önceki Atlas yazısında, CoreWeave, Nebius, Lambda ve Crusoe gibi neocloud'ların yapay zekâ compute kapasitesini nasıl bir hizmete ve finansman modeline dönüştürdüğüne baktık.
Orada geride kalan soru şuydu: Bu şirketlerin sattığı compute kapasitesi fiziksel olarak nasıl üretiliyor?
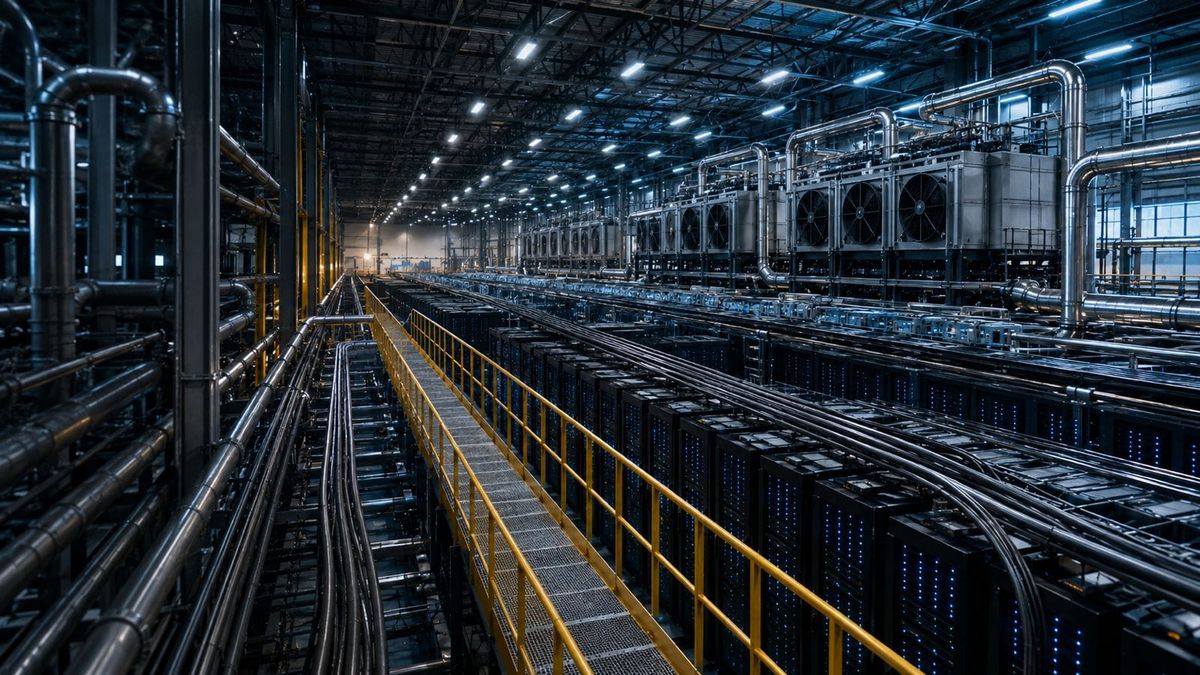
Bir modelin birkaç saniyede verdiği yanıtın arkasına baktığımızda çiplerden çok daha büyük bir sistemle karşılaşıyoruz. GPU'ları bir araya getiren rack'ler, yüksek hızlı ağlar, megavatlarca elektrik, sıvı soğutma, trafo merkezleri, fiber bağlantılar, arazi, inşaat ve bütün bunları finanse edecek sermaye aynı üretim sisteminin parçaları haline geliyor.
Üstelik bu katmanlar artık birbirinden bağımsız tasarlanamıyor. GPU seçimi rack yoğunluğunu, rack yoğunluğu güç dağıtımını ve soğutmayı, güç ihtiyacı ise tesisin lokasyonunu ve şebeke bağlantısını etkiliyor.
Son dönemde giderek daha sık duyduğumuz “AI factory”, yani yapay zekâ fabrikası kavramı bu dönüşümü anlatmaya çalışıyor.
Kavramın bugün en güçlü savunucusu NVIDIA. Bu nedenle AI factory ifadesini tarafsız ve yerleşik bir endüstri standardı gibi kullanmak doğru olmaz. NVIDIA yalnızca GPU değil; networking, sistem yazılımı, reference design ve tesis seviyesine kadar uzanan bir altyapı mimarisi sunuyor.
Fakat kavramın arkasındaki fiziksel değişim gerçek.
Asıl soru şu: Bir veri merkezi ne zaman yalnızca veri merkezi olmaktan çıkıp bir zekâ üretim tesisine dönüşür?
Veri merkezinden AI fabrikasına
Geleneksel veri merkezleri web uygulamaları, veritabanları, depolama, sanal makineler ve kurumsal sistemler gibi çok farklı iş yüklerini aynı fiziksel altyapı üzerinde çalıştırmak üzere tasarlanabilir.
Büyük ölçekli AI training ve inference iş yükleri farklı bir fiziksel profil yaratıyor. Çok sayıda hızlandırıcının aynı hesaplama işi üzerinde birlikte çalışması, işlemciler arasında büyük miktarda veri taşınması ve giderek daha yoğun rack'lerin beslenip soğutulması gerekiyor.
Bu nedenle performansı artık yalnızca GPU'nun teorik işlem gücü belirlemiyor. Bellek, networking, güç, soğutma ve yazılım katmanının birlikte ne kadar verimli çalıştığı da sonucu belirliyor.
NVIDIA'nın DSX platformu bu değişimi oldukça açık gösteriyor. DSX; AI fabrikalarını tasarlamak, simüle etmek, kurmak ve işletmek için reference design, API ve yazılım bileşenlerini bir araya getiriyor. Tesis tarafındaki reference design ise site, power, cooling, controls, connectivity ve compute sistemlerini aynı kampüs bağlamında ele alıyor.
Ağustos 2026 tarihli örnek DSX tesis tasarımı 250 MW sınıfında IT yükü, 1.536 GPU rack'i ve 110.592 GPU ölçeğine kadar uzanıyor. Bunlar gerçek bir tesisin açıklanmış kapasitesi değil, reference design içindeki örnek boyutlandırma değerleri. Ama AI altyapısının artık rack seviyesinden kampüs seviyesine kadar birlikte tasarlandığını göstermesi açısından önemli.
Bu nedenle AI fabrikasını yalnızca daha büyük bir veri merkezi olarak görmek eksik kalıyor. Compute ile tesis mühendisliği aynı üretim sisteminin parçalarına dönüşüyor.
Kaynaklar:
NVIDIA DSX Facilities Infrastructure Reference Design ↗
Yeni stratejik kaynak: Land, Power and Shell
17 Ağustos 2026'da NVIDIA ile SB Energy'nin açıkladığı PORTS-Pike anlaşması bu dönüşümün en çarpıcı örneklerinden biri.
Ohio'daki PORTS-Pike Technology Campus için NVIDIA, ilk aşamada 4,25 IT-GW kapasiteyi destekleyecek arazi, enerji ve bina kabuğu için kredi desteği sağlayacak. Kalan kapasite için opsiyonla toplam ölçek 8 IT-GW'a kadar çıkabiliyor. OpenAI bu kapasitenin müşterisi olacak; SB Energy ise tesisi 20 yıllık kira kapsamında inşa edecek, sahip olacak ve işletecek. Kapasitenin 2028'den itibaren aşamalar halinde devreye alınması planlanıyor.
Enerji tarafı da aynı ölçekte büyüyor. SB Energy ve SoftBank en az 10 GW yeni enerji üretimi ve 4,2 milyar dolarlık bölgesel şebeke yatırımı planlıyor. NVIDIA ayrıca SB Energy'ye 1,5 milyar dolar yatırım yapacağını açıkladı.
Buradaki kritik üç kelime Land, Power and Shell, kısaca LPS: arazi, enerji ve veri merkezinin fiziksel kabuğu.
Bir süre önce AI altyapısındaki kritik kaynak denildiğinde ilk akla gelen GPU'ydu. Ardından HBM ve advanced packaging kapasitesi görünür hale geldi. Şimdi ise GPU'yu satın alabilmek tek başına yeterli değil. Onu çalıştırabileceğiniz, yeterli enerjiye ve bağlantıya sahip fiziksel kapasitenin de zamanında hazır olması gerekiyor.
Jensen Huang'ın PORTS-Pike duyurusunda LPS'yi AI çağının temel kaynaklarından biri olarak öne çıkarması bu nedenle önemli. Gelecekteki compute artık yalnızca silikon tedarikiyle değil, silikonun kurulacağı uzun ömürlü fiziksel altyapıyla birlikte planlanıyor.
Kaynak:
Enerji neden compute'un bir parçası?
AI fabrikalarının ölçeğini anlamak için gigawatt kavramını ciddiye almak gerekiyor.
Ocak 2026'da OpenAI ve SoftBank Group, SB Energy'ye toplam 1 milyar dolar yatırım yaptı. OpenAI aynı zamanda SB Energy'yi Texas Milam County'deki 1,2 GW veri merkezi sahasını inşa edip işletmek üzere seçti.
Bu büyüklükte projelerde elektrik artık veri merkezinin arka plandaki yardımcı girdisi değil. Tesisin kurulup kurulamayacağını ve ne kadar hızlı devreye alınabileceğini belirleyen temel girdilerden biri.
Uluslararası Enerji Ajansı'nın (IEA) Energy and AI çalışmasına göre veri merkezlerinin küresel elektrik tüketimi 2024'te yaklaşık 415 TWh seviyesindeydi. IEA'nın baz senaryosu bunun 2030'da yaklaşık 945 TWh'ye çıkarak iki kattan fazla artmasını öngörüyor. Ajans aynı zamanda veri merkezlerinin coğrafi olarak yoğunlaşmasının yerel şebekeler üzerindeki etkisini özellikle vurguluyor.
ABD Enerji Bakanlığı'nın Temmuz 2026'da yayımladığı taslak National Transmission Needs Study de veri merkezleri ve diğer büyük yeni yüklerin ek iletim altyapısı ihtiyacını artırdığını belirtiyor. Çalışma hâlen taslak olduğu için bunu nihai politika kararı değil, güncel bir şebeke ihtiyacı değerlendirmesi olarak okumak gerekiyor.
Burada iki farklı zaman ölçeği çarpışıyor: compute teknolojisi çok hızlı yenilenirken enerji ve iletim altyapısı çok daha uzun planlama ve inşa sürelerine ihtiyaç duyuyor. Bu nedenle AI yarışında yalnızca en iyi çipe sahip olmak değil, elektriğe ne kadar hızlı erişebildiğiniz de rekabet avantajına dönüşüyor.
Kaynaklar:
U.S. Department of Energy, National Transmission Needs Study ↗
Rack artık tek başına bir IT ekipmanı değil
NVIDIA'nın Vera Rubin platformu, compute, networking ve tesis altyapısının neden birlikte tasarlanmaya başladığını gösteren güncel örneklerden biri.
Rubin yalnızca yeni bir GPU nesli değil. Platform CPU, GPU, NVLink, Ethernet, DPU ve yazılım bileşenlerini rack ölçeğinde birlikte tasarlıyor. DPU, ağ ve altyapı işlemlerinin bir bölümünü ana CPU ve GPU'lardan alarak özel olarak işleyen programlanabilir işlemci sınıfı olarak düşünülebilir.
21 Temmuz'da NVIDIA, Vera Rubin NVL72 rack'lerinin CoreWeave, Google Cloud, Microsoft Azure, Oracle Cloud Infrastructure ve Nebius'ta çalıştığını açıkladı. Aynı açıklamada CoreWeave'in DeepSeek-R1 üzerinde Grace Blackwell NVL72'ye kıyasla megawatt başına 10 kata kadar daha yüksek throughput gördüğü raporlandı.
Bu ölçüm NVIDIA ve partner verisine dayanıyor; bağımsız bir endüstri benchmark'ı gibi değerlendirilmemeli. Ama kullanılan ölçüm birimi önemli: performans artık yalnızca GPU başına değil, güç bütçesi başına üretilen çıktı üzerinden de tartışılıyor.
Yeni nesil compute'u devreye almak da artık tek bir çip teslimatı değil. Rack, ağ, güç, soğutma ve yazılım stack'inin birlikte hazır olması gerekiyor.
Kaynak:
Networking: fabrikanın konveyör bandı
Bir fabrikada makinelerin tek tek güçlü olması yeterli değildir. Üretim hattındaki akışın da makineleri bekletmemesi gerekir. Büyük AI cluster'larında networking benzer bir rol oynuyor.
Dağıtık training ve büyük ölçekli inference sırasında hızlandırıcılar sürekli veri alışverişi yapıyor. Ağ tıkandığında pahalı GPU'lar veri bekleyebiliyor. Bu nedenle AI için tasarlanan yeni nesil Ethernet çözümleri yalnızca daha yüksek port hızına değil, trafiği yoğun olmayan yollara yönlendiren adaptive routing ve tıkanıklığı algılayıp akışı düzenleyen congestion control gibi mekanizmalara da odaklanıyor.
NVIDIA Spectrum-X bu yaklaşımın örneklerinden biri. ConnectX-8 neslinde 800 Gb/s bağlantı ve telemetry tabanlı congestion control öne çıkıyor. Ama asıl mesele tek başına hız değil: GPU'lar arasındaki yoğun east-west trafiğini daha öngörülebilir hale getirmek.
AI fabrikası yüz binlerce hızlandırıcıya doğru büyüdükçe ağ, compute'un yanında ikincil bir bileşen olmaktan çıkıyor. Teorik compute kapasitesinin gerçekten kullanılabilir kapasiteye dönüşüp dönüşmeyeceğini belirleyen ana katmanlardan biri haline geliyor.
Kaynak:
NVIDIA ↗
Soğutma: görünmeyen sınır
Rack yoğunluğu arttıkça güç ve ısı yoğunluğu da artıyor. NVIDIA'nın güncel DSX örnek tasarımında cabinet TDP değerleri yaklaşık 198 kW'tan Vera Rubin NVL72 için 330 kW'a kadar çıkıyor. Bu seviyelerde liquid cooling ve tesis seviyesindeki ısı atım sistemleri compute mimarisinin doğrudan parçasına dönüşüyor.
Bu nedenle soğutma artık yalnızca bina mühendisliğinin arka planındaki bir konu değil. Desteklenebilen rack yoğunluğunu, kullanılabilir compute miktarını ve aynı güç bütçesinden alınabilen çıktıyı doğrudan etkiliyor.
Bu konuyu ileride Atlas'ta ayrı bir yazıda daha derin ele alacağız. Burada önemli olan bağlantı şu: soğutma, fiziksel tasarım ile inference ekonomisi arasında doğrudan bir köprü kuruyor.
Kaynak:
NVIDIA DSX Facilities Infrastructure Reference Design ↗
AI fabrikasının finansmanı
AI altyapısının ölçeği büyüdükçe mesele yalnızca mühendislik olmaktan çıkıyor. On milyarlarca dolarlık tesislerin ve compute kapasitesinin kim tarafından, hangi sözleşmelerle ve hangi risk varsayımlarıyla finanse edileceği de sistemin parçası haline geliyor.
10 Ağustos 2026'da NVIDIA; Apollo, BlackRock, Blackstone, Brookfield, Goldman Sachs ve KKR ile bağımsız AI compute altyapısı finansman platformları oluşturmak için stratejik ortaklıklar açıkladı. Hedef, zaman içinde 500 milyar doların üzerinde üçüncü taraf sermayeyi AI altyapısına çekmek.
Bir gün sonra Jensen Huang bunu daha açık bir çerçeveye oturttu: “AI factory compute”un yatırım yapılabilir bir altyapı varlık sınıfına dönüşebileceğini savundu.
A100 örneğini de bu tezin kanıtlarından biri olarak gösteriyor. NVIDIA'ya göre 2020'de piyasaya çıkan A100, altı yıl sonra training, fine-tuning, inference ve HPC için ticari kullanımda kalmaya devam ediyor; CUDA'daki yazılım geliştirmeleri de kurulu donanımın ekonomik ömrünü uzatabiliyor.
Burada önemli bir ayrım var. Bunlar NVIDIA'nın kendi ekonomik tezi. Bir GPU'nun fiziksel olarak çalışmaya devam etmesi ekonomik değerini otomatik olarak koruduğu anlamına gelmiyor. Müşteri talebi, kullanım oranı, nakit akışı ve kalan ekonomik değer ayrı ayrı değerlendirilmek zorunda.
Dolayısıyla “AI compute artık kesin olarak yeni bir altyapı varlık sınıfıdır” demek için erken. Fakat sermayenin compute'a bakışının değişmeye başladığı açık.
PORTS-Pike bu yeni yapıyı somutlaştırıyor: SB Energy tesisi geliştiriyor ve işletiyor, OpenAI uzun vadeli müşteri oluyor, NVIDIA compute platformunu ve LPS tarafındaki desteği getiriyor, enerji ve şebeke yatırımları ayrı aktörlerle ilerliyor.
AI fabrikası teknik bir sistem olduğu kadar sözleşmelerden ve sermaye ilişkilerinden oluşan ekonomik bir sisteme dönüşüyor. Bu bağlantının finansman tarafını bir önceki NeoCloud yazısında daha ayrıntılı ele almıştık.
Kaynaklar:
Jensen Huang, NVIDIA, 11 Ağustos 2026 ↗
Yeni bir sanayi coğrafyası
Gigawatt ölçeğinde AI kapasitesi her yere aynı kolaylıkla kurulamaz. Enerji erişimi, fiber, arazi, izin süreçleri, soğutma koşulları, mühendislik kapasitesi ve tedarik zinciri lokasyonu yeniden stratejik hale getiriyor.
Japonya'nın Temmuz 2026'da duyurduğu FRONTia altyapısı bunun iyi bir örneği. NVIDIA ve Noetra, Japonya Ekonomi, Ticaret ve Sanayi Bakanlığı tarafından desteklenen proje için 13.750 Vera CPU ve 27.500 Rubin GPU içeren, 140 MW veri merkezi kapasitesine sahip bir Vera Rubin AI factory kurmayı planlıyor. Sistem DSX mimarisini ve Spectrum-X Ethernet'i kullanacak.
Buradaki önemli nokta rakamlardan daha büyük: AI fabrikaları yalnızca teknoloji şirketlerinin bilançosunu değil, sanayi politikasını ve ülkelerin compute erişimini de etkilemeye başlıyor.
Buradan Kontrol Zinciri'ne uzanan ayrı bir soru doğuyor: zekâ üretmek için gerekli fiziksel kapasite belirli şirketlerde, bölgelerde ve sermaye havuzlarında yoğunlaşırsa bu kapasitenin kontrolü kimde olacak?
Bu konuyu Atlas'ta ileride ayrıca ele alacağız.
Kaynaklar:
AI fabrikası gerçekten fabrika mı?
Kavramı fazla ileri götürmemek gerekiyor.
AI fabrikaları otomobil veya çelik fabrikaları gibi fiziksel ürün üretmiyor. “Token”, “intelligence” veya “compute” kavramlarını klasik endüstriyel ürünlerle birebir eşitlemek yanıltıcı olabilir. Ayrıca AI factory teriminin bugün NVIDIA tarafından güçlü biçimde şekillendirildiğini unutmamak gerekiyor.
Fakat analoji önemli bir şeyi görünür kılıyor: yapay zekâ ölçeklendikçe üretim fonksiyonu giderek daha fiziksel hale geliyor.
Girdi olarak elektrik, silikon, veri, sermaye ve mühendislik kapasitesi alıyor. Bunları compute aracılığıyla işliyor. Çıktı olarak training kapasitesi, inference, token, tahmin, simülasyon veya ajan eylemi üretiyor.
Bu açıdan AI fabrikası, yapay zekânın yalnızca yazılım ekonomisi içinde değil, endüstriyel altyapı ekonomisi içinde de değerlendirilmesi gerektiğini anlatan faydalı bir çerçeve.
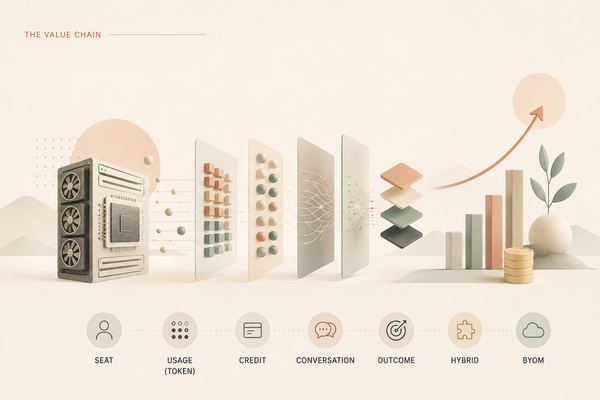
Fiziksel Zincir'den Değer Zinciri'ne
Yapay zekâ yarışının ilk yıllarında dikkat modellerdeydi. Sonra GPU'lar görünür hale geldi. Ardından HBM, advanced packaging, networking, enerji ve soğutma darboğazlarını konuşmaya başladık.
AI fabrikası kavramı bütün bu parçaları tek bir sistem içinde görmemizi sağlıyor.
Bir model ne kadar güçlü olursa olsun onu çalıştıracak compute yoksa ölçeklenemez. Compute varsa ama enerji veya uygun tesis yoksa devreye alınamaz. Rack'ler kurulsa ama networking ve soğutma yetersizse teorik kapasitenin tamamı kullanılamaz. Bütün fiziksel altyapı hazır olsa bile yeterli kullanım ve ekonomik talep yoksa yatırımın ekonomisi çalışmaz.
Bu nedenle AI Fabrikaları, The Intelligence Atlas'ın Fiziksel Zincirinde doğal bir dönüm noktası oluşturuyor.
Bir önceki yazıda NeoCloud'ların compute kapasitesini nasıl bir hizmet ve finansman modeline dönüştürdüğüne baktık. Bu yazıda ise o kapasitenin fiziksel olarak nasıl üretildiğini gördük.
Şimdi soru değişiyor:
Bu kadar büyük fiziksel kapasite kurulduktan sonra ekonomik değere nasıl dönüşüyor?
Fiziksel kapasite → utilization → inference → maliyet → ekonomik değer.
Atlas'ın bundan sonraki rotası bizi bu nedenle Değer Zinciri'ne ve Inference Ekonomisi'ne götürüyor.
Yapay zekâ Atlası'nda keşfetmeye devam edeceğiz. Bir sonraki yazıda görüşmek üzere.
How to Cite
M. Seçkin Bedük, “AI Fabrikaları: Zekânın Fiziksel Üretim Sistemi,” The Intelligence Atlas, 2026.