Bir Yapay Zekâ Cevabının Gerçek Maliyeti Nedir?
Bir AI cevabının maliyeti token fiyatından ibaret değil. Silikondan compute kapasitesine, inference ve model routing’den agent bütçelerine ve ekonomik değere uzanan zinciri takip ediyoruz.
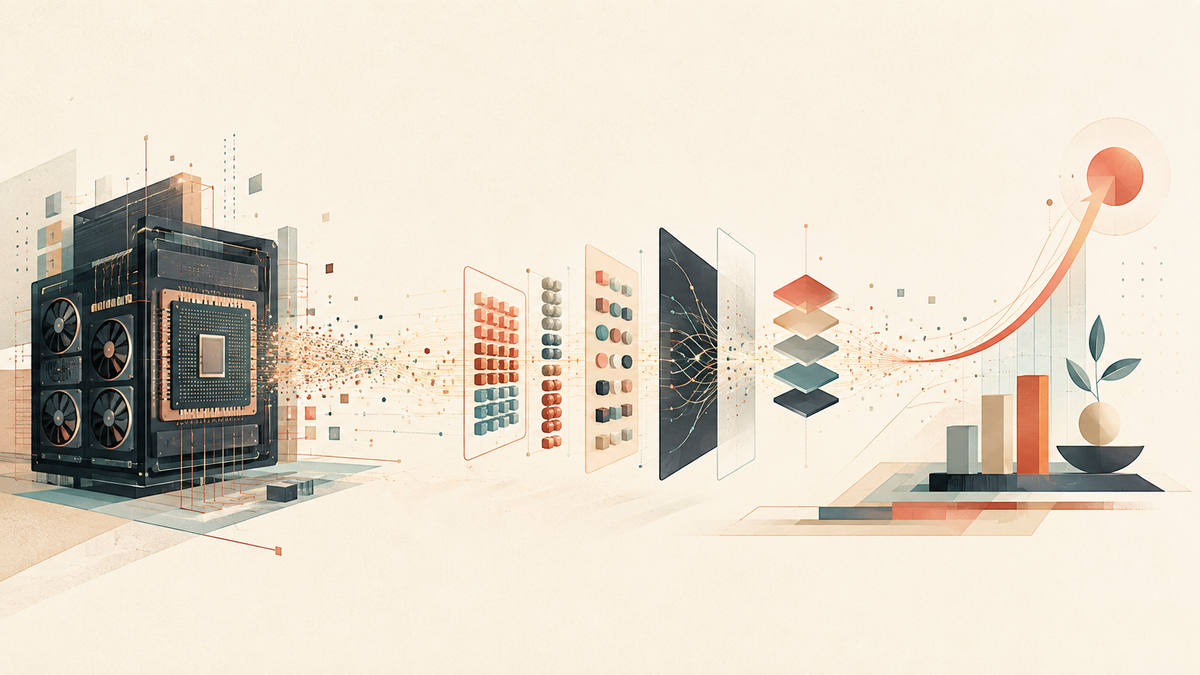
Ekranda birkaç satır, arkada bir ekonomi
Bir yapay zekâ modeline soru sorduğumuzda cevap birkaç saniye içinde geliyor.
Bu deneyim o kadar basit ki, arkasındaki ekonomik sistemi görmek kolay değil.
Bir soru yazıyoruz. Model cevap veriyor. API kullanıyorsak faturada input token ve output token görüyoruz. Böyle bakınca yapay zekânın maliyeti de oldukça basitmiş gibi duruyor: kaç token kullandık ve her token için ne kadar ödedik?
Ama gerçekte bir yapay zekâ cevabının maliyeti token fiyatından çok daha önce başlıyor.
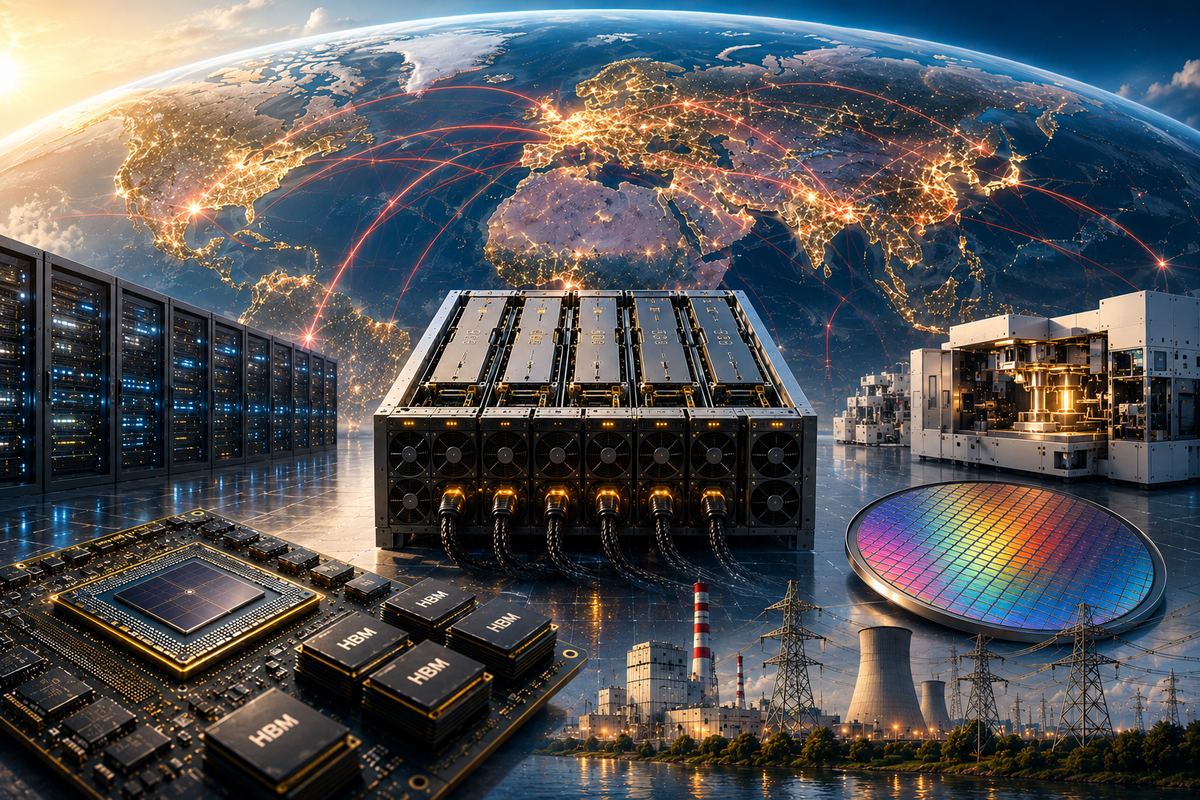
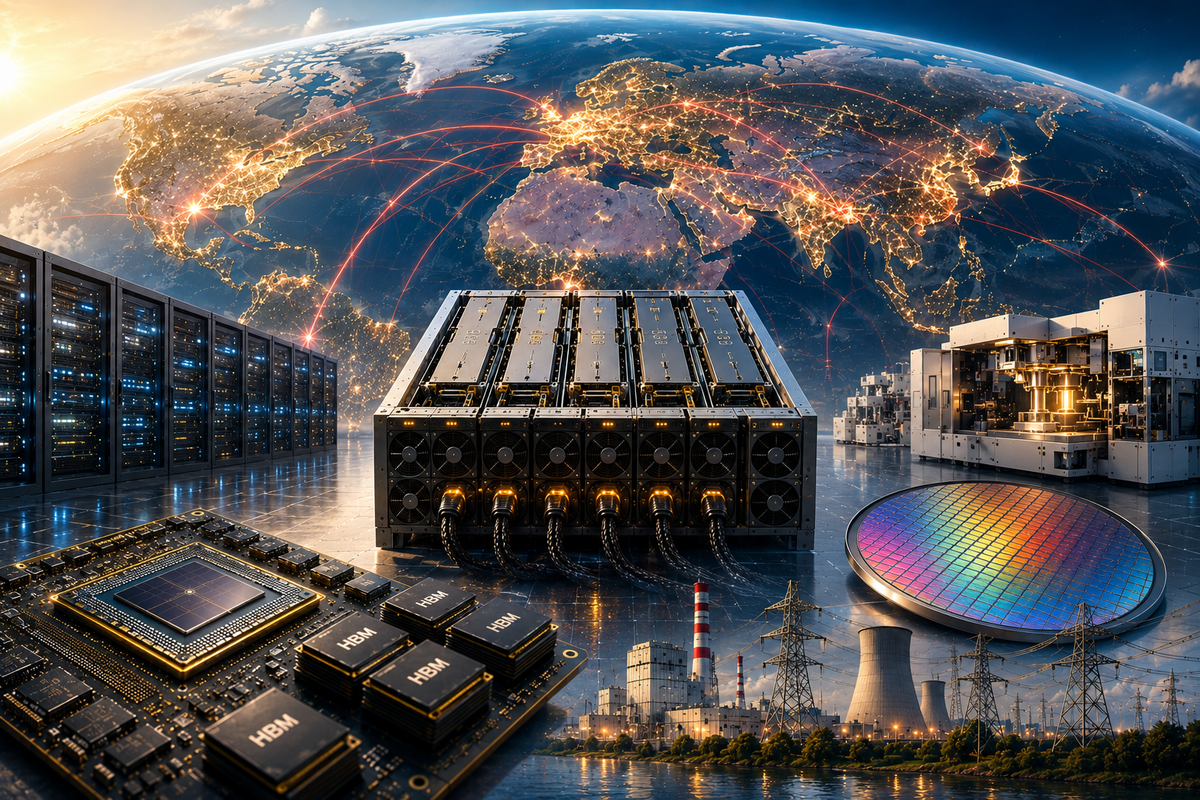
O token'ın üretilebilmesi için önce bir GPU'nun çalışması gerekiyor. GPU'nun HBM belleğe ihtiyacı var. Binlerce GPU birlikte çalışıyorsa yüksek hızlı networking gerekiyor. Bütün sistem elektrik tüketiyor ve ortaya çıkan ısının uzaklaştırılması gerekiyor. Veri merkezi kapasitesinin satın alınması, kurulması veya kiralanması gerekiyor. Sonra inference engine bu donanımı ne kadar verimli kullandığımızı belirliyor. Hangi modelin seçildiği, context'in ne kadar uzun olduğu, cache kullanılıp kullanılmadığı, modelin kaç kez çağrıldığı ve bir agent'ın kaç tur çalıştığı toplam maliyeti değiştiriyor.
En sonunda da bütün bu harcamanın bir soruya dönüşmesi gerekiyor:
Ürettiğimiz şey gerçekten değer yarattı mı?
İşte AI Tokenomics tartışması tam olarak burada başlıyor.
Token maliyeti, AI maliyeti değildir
Linux Foundation, Tokenomics Foundation'ı resmen başlattı. Amaç, AI altyapısının ekonomisi için açık standartlar, benchmark'lar ve iyi uygulamalar geliştirmek. Foundation'ın tanımı özellikle önemli: AI Token Economics'i enerji ve sermayenin AI token'larına dönüştürülmesi, bu token'ların zekâ üretmek için verimli kullanılması ve sonunda değere dönüşmesiyle ilgilenen gelişmekte olan bir disiplin olarak tanımlıyor.
Buradaki “gelişmekte olan” ifadesi kritik. Çünkü Tokenomics henüz sınırları tamamen çizilmiş, bütün metrikleri üzerinde uzlaşılmış bir standart değil. Ama çözmeye çalıştığı problem çok gerçek.
Foundation'ın dikkat çektiği en önemli noktalardan biri şu:
Token'lar AI harcamasının yalnızca bir bölümünü temsil ediyor.
Bugün sektörün büyük bölümü “AI maliyeti” ile “token maliyeti”ni birbirine karıştırıyor. Bunun anlaşılır bir nedeni var. Token, ölçülmesi en kolay katman. OpenAI, Anthropic, Google veya başka bir model sağlayıcısından API kullandığınızda input ve output token miktarını görebiliyorsunuz. Birim fiyatı biliyorsunuz. İki rakamı çarpıp maliyeti hesaplayabiliyorsunuz.
Ama bu hesap bize yalnızca faturanın görünen kısmını anlatıyor.
AI'ın Görünmeyen İmparatorluğu yazısında bir yapay zekâ cevabının arkasındaki fiziksel dünyayı takip etmiştik. Modelden GPU'ya, HBM'den gelişmiş paketlemeye, foundry'lerden litografiye, enerji ve soğutmadan networking'e kadar uzanan küresel bir zincir görmüştük.
 M. Seckin Beduk
Şimdi aynı zincire başka bir açıdan bakalım.
Bu kez teknolojinin değil, paranın izini sürelim.
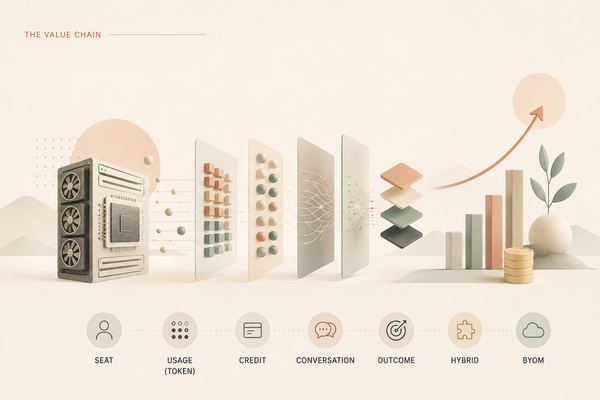
Silicon → Capacity → Inference → Model → Routing → Agent → Outcome → Economic Value
Bir token'ın gerçek maliyeti bu zincirin içinde oluşuyor.
Silicon: Token'ın fiziksel başlangıç noktası
Yapay zekâ ekonomisinin en altında hâlâ fizik var.
GPU ne kadar hızlı?
HBM ne kadar veri taşıyabiliyor?
GPU'lar birbirleriyle ne kadar hızlı haberleşebiliyor?
Bir rack ne kadar elektrik tüketiyor?
Ne kadar soğutma gerekiyor?
Bir watt elektrik karşılığında kaç token üretebiliyoruz?
Bu sorular yalnızca veri merkezi mühendislerinin problemi değil. Hepsi doğrudan AI ekonomisinin parçası.
NVIDIA son dönemde “tokens per second per watt” gibi metrikleri özellikle öne çıkarıyor. Bunun nedeni basit: aynı donanım ve enerji bütçesiyle daha fazla token üretebiliyorsanız, token factory'nizin ekonomisi iyileşiyor.
Burada ilginç bir bağlantı ortaya çıkıyor.
Yapay zekâ altyapısının ısı ve soğutma problemine ileride ayrı bir yazıda döneceğiz. Şimdilik ekonomik bağlantıyı görmek yeterli: daha verimli cooling, aynı elektrik altyapısı içinde daha fazla gücün compute'a ayrılabilmesini sağlayabilir. Bu da daha fazla inference kapasitesi anlamına gelir.
Başka bir ifadeyle:
Cooling → Power Efficiency → Compute Capacity → Tokens → Economics
The Intelligence Atlas'ın farklı bölgeleri tam da burada birbirine bağlanıyor.
Capacity: Sahip olduğunuz GPU değil, kullandığınız GPU önemlidir
Bir şirketin yüzlerce GPU'ya sahip olması güçlü bir AI altyapısına sahip olduğu anlamına gelebilir. Ama ekonomik açıdan daha önemli bir soru vardır:
Bu GPU'ların ne kadarı gerçekten çalışıyor?
Kapasite satın almak ile kapasiteyi verimli kullanmak aynı şey değildir.
Cloud üzerinde provisioned throughput satın alabilirsiniz. GPU cluster kiralayabilirsiniz. Kendi veri merkezinizi kurabilirsiniz. Her durumda belirli bir kapasiteyi finanse edersiniz. Ancak talep o kapasiteyi doldurmuyorsa, kullanılmayan compute da maliyet üretir.
Bu nedenle AI ekonomisinde idle GPU klasik bulut dünyasındaki unused server probleminin çok daha pahalı bir versiyonuna dönüşebilir.
Microsoft Azure'un provisioned throughput modeli bu farkı iyi gösteriyor. Pay-as-you-go modelde tüketim arttıkça maliyet artarken, provisioned kapasitede belirli throughput'u önceden ayırıyorsunuz. Kullanım düşük kaldığında kapasitenin ekonomik yükü ortadan kalkmıyor.
Bu nedenle gerçek soru “Bir milyon token kaç dolar?” değil.
Daha doğru soru şu olabilir:
Satın aldığım compute kapasitesinden kaç yararlı token çıkarabiliyorum?
Inference: Aynı GPU, farklı ekonomi
Fiziksel donanım aynı kalsa bile inference software bütün ekonomik dengeyi değiştirebilir.
Büyük dil modellerinin inference sürecindeki en önemli sorunlardan biri bellektir. Model cevap üretirken önceki token'lara ilişkin bilgiler KV cache adı verilen yapılarda tutulur. Context uzadıkça bu cache büyür. Belleğin kötü yönetilmesi GPU'nun önemli bölümünün boşluklar ve verimsiz allocation nedeniyle kullanılamamasına yol açabilir.
vLLM'nin geliştirdiği PagedAttention yaklaşımı bu problemi çözmeye odaklandı. Akademik çalışmalarda vLLM, belirli test koşullarında aynı latency seviyesinde önceki serving sistemlerine göre iki ila dört kat daha fazla throughput gösterebildi.
Dikkat edilmesi gereken nokta rakamın kendisinden çok altında yatan fikir.
Yeni GPU satın almadan da token üretim kapasitesini artırabilirsiniz.
Continuous batching başka bir örnek. Geleneksel batching yaklaşımında bir gruptaki bütün isteklerin bitmesi beklenebilir. Continuous batching ise biten request'in yerine yenisini alarak GPU'nun mümkün olduğunca boş kalmamasını sağlar.
KV cache optimizasyonu, prefix caching, speculative decoding ve prefill ile decode fazlarının ayrılması da aynı ekonomik hedefe hizmet eder:
Elinizdeki compute'tan daha fazla faydalı inference çıkarmak.
Yani inference engine yalnızca teknik bir middleware değildir.
Bir ekonomik motordur.
Model: Her işe en güçlü modeli göndermek neden pahalıdır?
Bugün model sağlayıcılarının fiyat tablolarına baktığımızda büyük farklar görüyoruz.
Aynı sağlayıcı içinde bile frontier model ile daha küçük model arasında katlarca fiyat farkı olabiliyor. Cached input daha ucuz olabiliyor. Batch işlem indirimli olabiliyor. Output token çoğu zaman input token'dan çok daha pahalı olabiliyor.
Bunların hepsi bize aynı şeyi söylüyor:
Model seçimi artık yalnızca kalite kararı değildir. Ekonomik bir routing kararıdır.
Bir hukuk sözleşmesini analiz ederken en güçlü reasoning modelini kullanmak mantıklı olabilir. Ama e-postanın hangi departmana ait olduğunu sınıflandırmak için aynı modeli kullanmak büyük ihtimalle gereksizdir.
Bu nedenle AI ekonomisinin en önemli kavramlarından biri model right-sizing olmaya başlıyor.
Doğru işe, yeterince iyi olan en ekonomik modeli vermek.
Bu fikrin akademik karşılığı da oluşuyor. RouteLLM gibi çalışmalar, bir isteği güçlü model ile daha ekonomik model arasında dinamik olarak yönlendirmenin belirli benchmark'larda kaliteyi korurken maliyeti ciddi ölçüde düşürebildiğini gösteriyor.
Quantization da aynı katmanda çalışır. Modelin ağırlıklarını daha düşük precision ile temsil ederek daha az memory kullanmak ve belirli hardware üzerinde daha ekonomik inference elde etmek mümkün olabilir. Fakat bunun da kalite ve uyumluluk trade-off'ları vardır.
Yani “en ucuz model” diye tek bir cevap yoktur.
Doğru model, belirli bir iş için yeterli kaliteyi en düşük toplam maliyetle sağlayan modeldir.
Routing: Ekonomi burada yönetilmeye başlıyor
Bir kurum birden fazla model kullanmaya başladığında yeni bir katman ortaya çıkar.
Routing.
Hangi istek hangi modele gidecek?
Hangi model başarısız olursa hangisine fallback yapılacak?
Bir kullanıcının veya agent'ın günlük bütçesi ne olacak?
Hangi işlerde frontier model kullanılabilecek?
Hangi işlerde cached response yeterli olacak?
Hangi işlerde AI kullanmaya hiç gerek yok?
Tokenomics Foundation'ın ortaya koymaya çalıştığı disiplinin ilginç taraflarından biri burada ortaya çıkıyor. Ekonomi, product architecture ile birleşiyor.
Ve hemen ardından governance geliyor.
Çünkü routing yalnızca performans optimizasyonu değildir. Aynı zamanda policy enforcement mekanizmasıdır.
Bir agent'ın GPT, Claude veya Gemini arasında seçim yapması ekonomik karar olabilir. Ama aynı agent'ın üretim veritabanına yazma yetkisine sahip olması governance kararıdır.
Bu iki karar agentic sistemlerde giderek birbirine yaklaşıyor.
Agent: Bir cevap artık tek bir model çağrısı olmayabilir
Chatbot döneminde maliyet hesabı nispeten kolaydı.
Prompt girer.
Model cevap verir.
Agent döneminde ise kullanıcı aynı basit deneyimi yaşarken arka planda çok farklı bir süreç çalışabilir.
Agent önce isteği analiz eder.
Plan oluşturur.
Bilgi arar.
Bir aracı çağırır.
Sonucu değerlendirir.
Başka bir modele sorar.
Bir sub-agent görevlendirir.
Yanıtı kontrol eder.
Hata görürse tekrar dener.
Sonra nihai cevabı üretir.
Kullanıcı bir cevap görür.
Sistem onlarca işlem yapmış olabilir.
Google'ın güncel Gemini API fiyatlandırma belgelerinde agentic kullanımlardaki intermediate input ve reasoning token'larının da faturalandırılabildiği açıkça belirtiliyor. Bu küçük bir ayrıntı değil.
Agent ekonomisinin özünü anlatıyor.
Final output artık gerçek consumption'ı temsil etmiyor.
Bunun sonucunda yeni bir risk doğuyor: cost explosion.
Bir workflow n adım çalışıyorsa maliyet n ile büyüyebilir. Her adımda birkaç deneme veya tool call yapılıyorsa bu sayı daha da artar. Sisteme birden fazla agent dahil olduğunda maliyet yeni bir çarpan kazanır.
Ve eğer agent'ın termination condition'ı, bütçe sınırı veya retry limiti yoksa sistem kontrolsüz döngülere girebilir.
Burada Tokenomics ile Governance birbirine bağlanıyor.
Agent'a yetki vermek, aynı zamanda bütçe vermektir
AI Governance çoğu zaman güvenlik veya regülasyon konusu olarak düşünülüyor.
Ama agentic dünyada governance aynı zamanda ekonomik bir mekanizmaya dönüşüyor.
Bir agent hangi modeli kullanabilir?
Bir task için maksimum kaç dolar harcayabilir?
Kaç kez retry yapabilir?
Kaç sub-agent oluşturabilir?
Hangi araçları çağırabilir?
Hangi noktada insan onayı gerekir?
Ne zaman durmalıdır?
Bu sorular hem güvenlik hem maliyet sorularıdır.
Atlas'ın üç zinciri burada birleşiyor
Ben The Intelligence Atlas'taki konuları üç ana zincir üzerinden okuyorum. Physical Chain, yapay zekâyı mümkün kılan fiziksel altyapıyı; Value Chain, bu altyapının nasıl ekonomik değere dönüştüğünü; Control Chain ise yetki, politika ve sorumluluğun kimde toplandığını izliyor.
THE PHYSICAL CHAIN:
Chips → Compute → Energy → Cooling → Data Centers → Networks
Bu yazıda Value Chain ile Control Chain, routing ve agent katmanlarında birbirine bağlanıyor.
THE VALUE CHAIN:
Silicon → Capacity → Inference → Model → Routing → Agent → Outcome → Economic Value
THE CONTROL CHAIN:
Sovereignty → Governance → Policy → Permission → Action → Accountability
Routing ve Agent bu iki zincirin kesiştiği düğümlerdir.
AI Governance'ın ekonomik karşılığı tam olarak burada ortaya çıkar.
Cost per token'dan cost per outcome'a
Bütün bu zincirin sonunda asıl soru hâlâ cevapsızdır.
Peki AI bize ne kazandırdı?
Bir müşteri hizmeti agent'ı düşünelim.
Model A bir müşteri sorununu ortalama 5 cent'e çözmeye çalışıyor ama vakaların yalnızca yüzde 40'ını başarıyla sonuçlandırıyor.
Model B ise 20 cent harcıyor ama vakaların yüzde 90'ını çözebiliyor.
Cost per token veya cost per request baktığımızda Model A daha ucuz görünebilir.
Ama cost per resolved case hesapladığımızda sonuç tamamen değişebilir.
İşte bu nedenle AI ekonomisinin önümüzdeki büyük sıçraması cost per token'dan cost per outcome'a geçmek olacak.
Bunu birkaç katmanda düşünebiliriz:
Cost per token
→ Cost per request
→ Cost per task
→ Cost per successful outcome
→ Value per outcome
→ AI ROI
Token, ekonomik zincirin başlangıcıdır.
Outcome ise sonudur.
AI ucuzladıkça neden toplam harcama artabilir?
Burada ilk bakışta paradoksal görünen bir durum var.
AI modelleri giderek daha verimli hale geliyor. Daha küçük modeller güçleniyor. Caching ucuzluyor. Inference engines gelişiyor. Quantization yaygınlaşıyor. Birim zekânın maliyeti düşüyor.
O halde AI bütçelerinin de küçülmesi gerekmez mi?
Gerekmeyebilir.
Çünkü bir şey ucuzladığında daha fazla kullanım senaryosu ekonomik hale gelir.
Daha önce bir çalışan günde beş kez AI kullanırken elli kez kullanmaya başlayabilir. Bir chatbot tek model çağrısı yaparken bir agent aynı iş için yirmi farklı inference step çalıştırabilir. Daha ucuz inference daha uzun context, daha fazla reasoning ve daha fazla automation kullanımını teşvik edebilir.
Bu yüzden doğru ifade şu olabilir:
AI'ın birim maliyeti düşerken toplam AI harcaması büyüyebilir.
Başka bir deyişle, zekâ ucuzluyor olabilir ama aynı anda çok daha fazla zekâ tüketmeye başlıyoruz.
Ve belki de Tokenomics'in doğmasının asıl nedeni bu.
AI ekonomisinin yeni sorusu
FinOps, mühendislik, finans ve iş ekiplerini aynı veri etrafında buluşturarak teknoloji harcamasının iş değerini artırmayı ve finansal sorumluluk yaratmayı amaçlayan operasyonel bir çerçeve ve kültürel pratiktir. Bulut çağında bu disiplin, teknoloji harcamasını görünür ve yönetilebilir hale getirmeyi öğretti.
AI çağında aynı problem daha karmaşık biçimde geri geliyor.
Çünkü artık yalnızca compute, storage veya network kullanmıyoruz.
Zekâ tüketiyoruz.
Üstelik bu zekâ farklı modellerden, farklı altyapılardan ve giderek daha fazla kendi başına hareket eden agent'lardan geliyor.
Bu nedenle geleceğin AI platformlarında yalnızca model gateway veya observability dashboard görmeyeceğiz.
Ekonomik control plane'ler göreceğiz.
Hangi modelin kullanılacağını belirleyen routing politikaları.
Agent bütçeleri.
Token limitleri.
Cost attribution.
Outcome ölçümü.
Human approval.
Policy enforcement.
Chargeback.
ROI takibi.
Çünkü yapay zekâ üretime girdikçe mesele artık yalnızca “Çalışıyor mu?” olmayacak.
Yeni soru şu olacak:
Ürettiği zekâ, harcadığı paraya değiyor mu?
Sonuç: Bir token'ın yolculuğu
AI'ın Görünmeyen İmparatorluğu'nda bir yapay zekâ cevabının arkasındaki fiziksel dünyayı görmüştük.
 M. Seckin Beduk
Şimdi aynı cevabın ekonomik dünyasını görmeye başlıyoruz.
Bir token silikon üzerinde doğuyor.
Compute kapasitesinden geçiyor.
Inference engine tarafından üretiliyor.
Bir model tarafından şekillendiriliyor.
Routing katmanında yönlendiriliyor.
Bir agent tarafından kullanılabiliyor.
Bir göreve dönüşüyor.
Bir outcome üretiyor.
Ve ancak sonunda ekonomik değer yaratıyor.
Bu nedenle bir AI cevabının gerçek maliyetini anlamak için fiyat tablosuna bakmak yetmiyor.
Bütün zinciri görmek gerekiyor.
Belki de önümüzdeki dönemde AI ekonomisinin en önemli metriği “Bir milyon token kaç dolar?” olmayacak.
Çok daha önemli bir soru soracağız:
Bir dolar karşılığında ne kadar değer ürettik?
The Intelligence Atlas'ta bu ekonomik zinciri keşfetmeye devam edeceğiz. Bir sonraki yazıda görüşmek üzere.